Tener un asistente IA con documentos propios ya no es un proyecto de laboratorio reservado a grandes empresas tecnológicas. Hoy cualquier equipo con recursos modestos puede construir un sistema que responda preguntas usando sus propios manuales, contratos, bases de conocimiento o informes internos, sin depender de que esa información esté en los datos de entrenamiento de ningún modelo público. La diferencia entre hacerlo bien y hacerlo mal no está en el presupuesto: está en entender qué ocurre realmente dentro de esos sistemas.
Por qué los modelos genéricos no bastan para uso interno
ChatGPT, Claude o Gemini conocen muchísimo sobre el mundo, pero no saben nada sobre tu empresa. No conocen tu catálogo de productos actualizado a marzo de 2025, ni tu procedimiento de onboarding específico, ni la versión 3.2 de tu contrato marco con distribuidores. Cuando un empleado pregunta a un modelo genérico sobre ese tipo de contenido, el modelo improvisa, y eso en un contexto empresarial es un problema real.
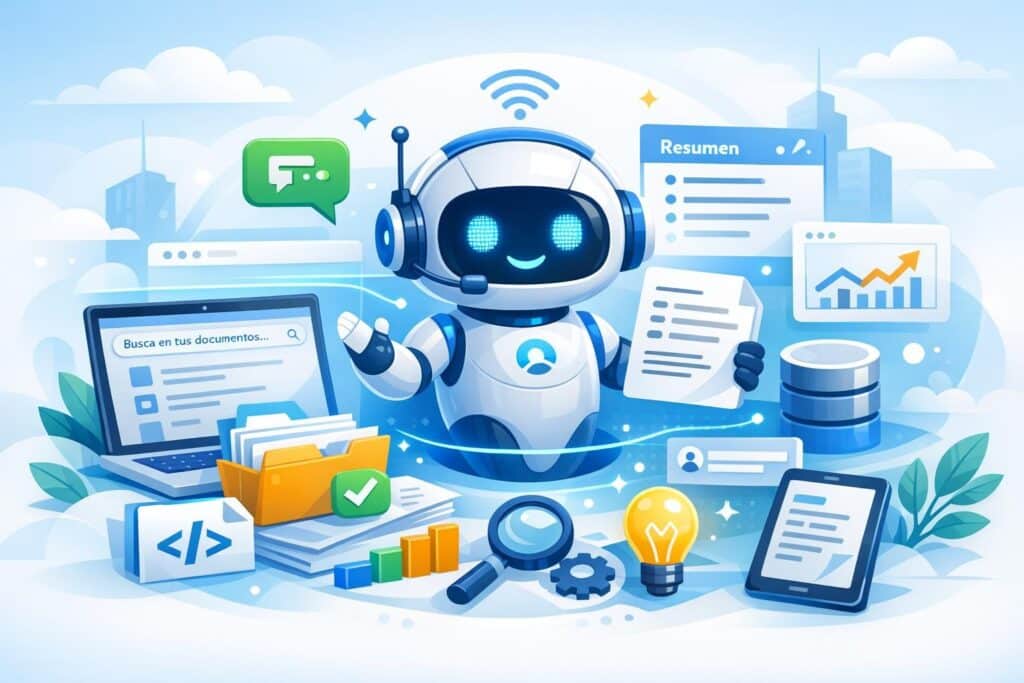
La solución técnica que resuelve esto se llama RAG (Retrieval-Augmented Generation, o generación aumentada con recuperación). El concepto es más sencillo de lo que parece: en lugar de pedirle al modelo que «recuerde» algo que nunca aprendió, el sistema busca primero el fragmento relevante en tus documentos y se lo entrega al modelo como contexto antes de generar la respuesta. El modelo no inventa; lee y sintetiza.
Arquitectura básica de un asistente entrenado con tus documentos
Antes de elegir herramienta o proveedor, conviene entender los tres bloques que componen cualquier sistema de este tipo, porque las decisiones de diseño en cada uno condicionan el resultado final.
Ingestión y procesamiento de documentos
El primer paso es convertir tus archivos en algo que el sistema pueda buscar. Los documentos (PDFs, Word, Notion, páginas web, hojas de cálculo) se fragmentan en trozos de texto llamados «chunks». El tamaño de cada chunk importa: demasiado pequeño y pierdes contexto; demasiado grande y el sistema recupera texto irrelevante junto con lo útil. Un rango habitual está entre 300 y 800 tokens por fragmento, aunque el valor óptimo depende del tipo de documento.
Cada fragmento se convierte después en un vector numérico mediante un modelo de embeddings. Ese vector captura el significado semántico del texto, lo que permite buscar por similitud conceptual y no solo por coincidencia de palabras exactas. Si un manual dice «baja de tensión» y el usuario pregunta «caída de voltaje», el sistema puede relacionarlos.
Almacenamiento y recuperación
Los vectores se guardan en una base de datos vectorial. Las opciones más usadas en 2025 son Pinecone, Weaviate, Qdrant y pgvector (esta última integrada en PostgreSQL, lo que simplifica la infraestructura si ya usas esa base de datos). Cuando el usuario hace una pregunta, el sistema la convierte también en un vector y busca los fragmentos más similares semánticamente. Normalmente recupera entre tres y ocho fragmentos, que forman el contexto que se pasa al modelo.
Generación de la respuesta
Con los fragmentos recuperados, el sistema construye un prompt que incluye el contexto documental y la pregunta del usuario, y se lo envía a un modelo de lenguaje (GPT-4o, Claude 3.5 Sonnet, Mistral, LLaMA 3, entre otros). El modelo genera una respuesta basada en ese contexto. Si se configura correctamente, el asistente puede indicar de qué documento o sección proviene cada afirmación, lo que reduce el riesgo de alucinaciones y permite verificar la fuente.
Si te interesa profundizar en cómo estos sistemas se conectan con flujos de trabajo más amplios, el artículo sobre agentes de IA personalizados para tu negocio aborda la capa de automatización que puede añadirse encima de este tipo de arquitectura.
Herramientas para construirlo sin escribir código desde cero
Existen tres caminos según el nivel técnico del equipo y el grado de personalización que se necesite.
Plataformas sin código o con poco código
Herramientas como Dify, Flowise o Botpress permiten montar un asistente con documentos propios mediante interfaces visuales. Suben los archivos, configuran el pipeline de RAG con controles deslizantes y conectan el modelo que prefieren. En menos de una hora es posible tener un prototipo funcional. La contrapartida es que la personalización tiene un techo y el control sobre cómo se procesan los documentos es limitado.
Notion AI, Guru o Glean van un paso más allá al integrarse directamente con las fuentes de datos que ya usa el equipo (Confluence, Google Drive, Slack, Salesforce), lo que elimina el paso de subir documentos manualmente. Son opciones sólidas para equipos que priorizan la velocidad de despliegue sobre el control técnico.
Frameworks de desarrollo
LangChain y LlamaIndex son las dos librerías de Python más extendidas para construir sistemas RAG a medida. LangChain tiene un ecosistema más amplio de integraciones y es más flexible para pipelines complejos; LlamaIndex está especialmente optimizado para la ingestión y recuperación de documentos. Muchos equipos usan ambas en distintas partes del mismo sistema.
Con estos frameworks se puede controlar cada detalle: el tamaño de los chunks, la estrategia de recuperación (BM25, búsqueda híbrida, reranking), el modelo de embeddings y el modelo de generación. Eso también significa más tiempo de desarrollo y más superficie de error.
APIs de alto nivel
OpenAI ofrece la funcionalidad de «file search» en su API de Assistants, que gestiona internamente el almacenamiento vectorial y la recuperación. Anthropic permite pasar documentos directamente en el contexto de Claude gracias a su ventana de contexto de 200.000 tokens. Estas opciones son rápidas de implementar pero atan el sistema a un único proveedor y ofrecen menos transparencia sobre cómo se recupera la información.
Qué tipos de documentos funcionan mejor y cuáles dan problemas
No todos los documentos se comportan igual dentro de un sistema RAG. Los textos densos en prosa (manuales, procedimientos, artículos técnicos) funcionan muy bien porque los chunks conservan coherencia semántica. Las tablas, los PDFs con maquetación compleja o los documentos con muchas imágenes dan más problemas porque la extracción de texto pierde estructura.
Los documentos escaneados requieren un paso previo de OCR de calidad. Hay diferencias notables entre usar Tesseract (gratuito, aceptable), Adobe Extract API (preciso pero de pago) o modelos multimodales como GPT-4o Vision para extraer texto de imágenes complejas.
Las hojas de cálculo merecen atención especial. Si el usuario va a hacer preguntas sobre datos numéricos, un sistema RAG puro no es la mejor arquitectura: es mejor combinar el asistente con capacidades de análisis de código o conectarlo directamente a la fuente de datos. En nuestro artículo sobre IA para análisis de datos hay más detalle sobre ese tipo de casos.
Los errores más frecuentes al construir este tipo de sistemas
El primero y más habitual: subir todos los documentos de la empresa sin filtrar. Un sistema RAG no mejora por tener más documentos; puede empeorar si hay documentos contradictorios, desactualizados o irrelevantes. La calidad del corpus documental es el factor que más condiciona la calidad de las respuestas.
El segundo error es no gestionar la actualización del índice. Los documentos cambian, los procedimientos se revisan y los precios se actualizan. Si el pipeline de ingestión no está automatizado, el asistente acaba respondiendo con información obsoleta sin que el usuario lo sepa.
El tercero es ignorar la evaluación del sistema. Muchos equipos ponen en marcha el asistente y asumen que funciona bien porque las primeras respuestas parecen correctas. Medir la precisión de la recuperación (¿está devolviendo los chunks adecuados?) y la calidad de la generación (¿la respuesta es fiel al contexto recuperado?) requiere construir un conjunto de preguntas de prueba con respuestas esperadas y ejecutarlo periódicamente. Herramientas como RAGAS o TruLens facilitan ese proceso de evaluación.
También conviene pensar en los límites de acceso. Si la empresa tiene documentos con distintos niveles de confidencialidad, el sistema necesita gestionar permisos: que un empleado de ventas no pueda acceder a través del asistente a documentos de RRHH aunque estén en el mismo corpus. Esto añade complejidad al diseño pero es un requisito que aparece casi siempre en entornos corporativos reales. El artículo sobre límites legales de la personalización con IA toca algunas de las implicaciones regulatorias que hay que tener en cuenta.
Modelos locales versus modelos en la nube
Una de las decisiones con más impacto es dónde corre el modelo de lenguaje. Usar la API de OpenAI o Anthropic es cómodo y los modelos son potentes, pero implica que los documentos y las preguntas de los usuarios pasan por servidores externos. En sectores como el legal, la salud o las finanzas, eso puede ser un problema de cumplimiento normativo.
La alternativa es desplegar un modelo de código abierto en infraestructura propia: LLaMA 3, Mistral, Phi-3 o Qwen2 son opciones capaces de dar buenas respuestas en tareas de pregunta-respuesta sobre documentos, siempre que el hardware lo permita. Un modelo de 7 u 8 mil millones de parámetros corre razonablemente bien en una GPU A10G o similar, que cuesta alrededor de 1,5 dólares por hora en AWS o Google Cloud si no se justifica la inversión en hardware propio.
La brecha de calidad entre los mejores modelos abiertos y GPT-4o o Claude 3.5 se ha reducido mucho en 2024 y 2025, sobre todo en tareas que no requieren razonamiento complejo. Para un asistente de soporte interno que responde preguntas sobre procedimientos, un modelo local de calidad suele ser suficiente.
Si quieres una perspectiva más amplia sobre qué herramientas están adoptando realmente los equipos de marketing y comunicación para tareas similares, puedes ver el análisis de herramientas de IA en equipos de marketing.
Casos de uso donde este tipo de asistente aporta más valor
Los casos donde el retorno es más claro y rápido comparten una característica: hay mucho conocimiento acumulado en documentos que los equipos consultan con frecuencia pero que es difícil de localizar.
El soporte interno de IT o RRHH es uno de ellos. Preguntas sobre políticas de empresa, beneficios, procedimientos de baja o configuración de herramientas se responden una y otra vez. Un asistente con acceso al manual del empleado y a la documentación técnica puede resolver entre el 60% y el 80% de esas consultas sin intervención humana, según datos de empresas que han desplegado este tipo de sistemas.
La atención al cliente técnico es otro caso con mucho recorrido. Si el producto tiene documentación extensa (manuales de instalación, guías de configuración, FAQs técnicas), un asistente puede guiar al cliente paso a paso sin que un agente humano tenga que buscar la sección correcta en un PDF de 300 páginas. En el artículo sobre chatbots con IA para atención al cliente hay una guía detallada de cómo estructurar ese tipo de implementaciones.
Los equipos legales y de cumplimiento también sacan mucho partido: búsqueda rápida en contratos, identificación de cláusulas específicas, comparación entre versiones de documentos. Y los equipos de ventas, que necesitan acceder rápidamente a fichas de producto, condiciones comerciales o casos de éxito durante una llamada.
Cómo medir si el asistente realmente funciona antes de lanzarlo
Antes de poner el sistema en manos de los usuarios, vale la pena construir un conjunto de evaluación con al menos 50 preguntas representativas, cubriendo los tipos de consulta más frecuentes y algunos casos límite donde la respuesta correcta no es obvia. Para cada pregunta se define qué respuesta sería aceptable y qué documentos deberían haber sido recuperados.
Con ese conjunto se pueden medir dos cosas de forma separada: la calidad de la recuperación (si el sistema está encontrando los fragmentos correctos) y la calidad de la generación (si el modelo está usando bien los fragmentos que recibe). Si la recuperación falla, el problema está en el tamaño de los chunks, el modelo de embeddings o la estrategia de búsqueda. Si la generación falla a pesar de una buena recuperación, el problema está en el prompt o en la elección del modelo.
Separar ambos puntos de fallo ahorra tiempo y evita cambiar cosas que no son el problema. Es también una práctica que conecta directamente con lo que se aplica en prompt engineering bien estructurado: ajustar el prompt antes de cambiar el modelo casi siempre da resultados más rápidos.
Una vez en producción, registrar las preguntas que el asistente no ha podido responder bien es la fuente más valiosa de información para mejorar el sistema. Esas preguntas indican qué documentos faltan, qué fragmentos se están cortando mal o qué reformulaciones del prompt resolverían casos frecuentes. Un asistente de IA con documentos propios no es un proyecto con fecha de entrega; es un sistema que mejora de forma continua si se le dedica atención regular.
Preguntas frecuentes
¿Cuánto cuesta aproximadamente montar un asistente con documentos propios si no quiero usar los servicios de OpenAI o Anthropic?
Si optas por un modelo local como LLaMA 3 o Mistral, el coste principal es el de la GPU necesaria para ejecutarlo. En proveedores como AWS o Google Cloud, una GPU A10G cuesta alrededor de 1,5 dólares por hora, lo que puede ser suficiente para un modelo de 7 u 8 mil millones de parámetros. Si el uso no es continuo, puedes arrancar la instancia solo cuando se necesite y reducir el coste mensual de forma considerable. A esto hay que sumar el coste de la base de datos vectorial, aunque opciones como pgvector, integrada en PostgreSQL, eliminan esa línea de gasto si ya usas esa base de datos.
¿Qué hago si mis documentos son PDFs escaneados o tienen tablas y maquetación compleja?
Los PDFs escaneados requieren un paso previo de OCR antes de poder procesarse en un sistema RAG. Puedes usar Tesseract si buscas una opción gratuita y aceptable, Adobe Extract API si necesitas mayor precisión, o modelos multimodales como GPT-4o Vision para documentos con imágenes o diseño muy complejo. En el caso de tablas con datos numéricos, un sistema RAG puro no es la arquitectura más adecuada: es mejor combinarlo con capacidades de análisis de código o conectarlo directamente a la fuente de datos original. Invertir tiempo en limpiar y estructurar bien los documentos antes de ingestionarlos es uno de los factores que más impacta en la calidad final de las respuestas.
¿Con qué herramienta empiezo si mi equipo no tiene perfil técnico pero quiero tener un prototipo rápido?
Para equipos sin perfil técnico, plataformas como Dify, Flowise o Botpress son el punto de entrada más razonable, ya que permiten configurar un pipeline RAG completo mediante interfaces visuales sin escribir código. En menos de una hora es posible tener un prototipo funcional subiendo los documentos y ajustando parámetros básicos con controles deslizantes. Si el equipo ya trabaja con herramientas como Google Drive, Confluence o Slack, opciones como Notion AI, Guru o Glean se integran directamente con esas fuentes y eliminan incluso el paso de subir archivos manualmente. El límite de estas plataformas es la personalización: cuando el caso de uso se vuelve más específico, será necesario pasar a frameworks como LangChain o LlamaIndex.
¿Cómo evito que el asistente responda con información desactualizada después de llevar meses en producción?
El problema de la información obsoleta aparece casi siempre en sistemas donde el pipeline de ingestión no está automatizado. La solución es configurar un proceso que detecte automáticamente cuando un documento se modifica o se añade uno nuevo, lo procese y actualice el índice vectorial sin intervención manual. Además, conviene establecer una política de revisión periódica del corpus documental para eliminar versiones antiguas de procedimientos, precios o contratos que puedan entrar en contradicción con los vigentes. Un asistente que responde con información desactualizada sin avisar al usuario genera una pérdida de confianza difícil de recuperar, por lo que este punto merece atención desde el diseño inicial del sistema.
¿Cómo sé si el asistente falla por culpa de la recuperación de documentos o por culpa del modelo que genera la respuesta?
La clave es medir ambos componentes por separado usando un conjunto de preguntas de prueba con respuestas esperadas y documentos de referencia definidos. Si el sistema recupera fragmentos incorrectos o irrelevantes, el problema está en el tamaño de los chunks, el modelo de embeddings o la estrategia de búsqueda, y hay que ajustar esas variables. Si los fragmentos recuperados son correctos pero la respuesta final no lo es, el problema está en el prompt o en la elección del modelo de generación, y modificar el prompt suele ser el primer paso antes de cambiar de modelo. Herramientas como RAGAS o TruLens automatizan buena parte de esta evaluación y permiten ejecutarla de forma periódica para detectar degradaciones a lo largo del tiempo.