Una auditoría de rendimiento web es el análisis sistemático que determina por qué una página tarda en cargar, qué recursos frenan al navegador y qué cambios técnicos producen una mejora real y medible. No es un proceso de una sola herramienta ni un informe automático que se descarga y se archiva: es un diagnóstico que requiere interpretar datos, priorizar problemas y tomar decisiones concretas. Este artículo recorre el proceso completo, desde las métricas que importan hasta las correcciones que más impacto tienen.
Por qué el rendimiento afecta mucho más que la experiencia del usuario
Google incorporó las Core Web Vitals como señal de ranking en 2021. Desde entonces, los tiempos de carga no son solo una cuestión de comodidad para el visitante: influyen directamente en el posicionamiento orgánico. Un estudio de Portent publicado en 2023 mostró que las páginas que cargan en un segundo convierten hasta tres veces más que las que tardan cinco. Y eso sin contar el efecto en la tasa de rebote, que crece de forma consistente con cada segundo adicional de espera.
El rendimiento también afecta a los crawlers. Googlebot tiene un presupuesto de rastreo limitado por sitio, y una web lenta consume ese presupuesto más despacio, lo que puede dejar páginas sin indexar. Si tienes un sitio con muchas URLs, esto se convierte en un problema real. Si además usas JavaScript de forma intensiva, el impacto se multiplica, porque el renderizado JavaScript y su efecto en el SEO añade una capa de complejidad que muchas auditorías ignoran.
Las métricas que debes medir antes de tocar nada
Una auditoría de rendimiento web que no parte de métricas claras no es una auditoría: es una lista de suposiciones. Estas son las que realmente importan.
Core Web Vitals
El Largest Contentful Paint (LCP) mide el tiempo hasta que el elemento más grande de la página queda visible. Google considera aceptable un LCP inferior a 2,5 segundos. El Interaction to Next Paint (INP) sustituyó al First Input Delay en marzo de 2024 y mide la latencia de respuesta ante cualquier interacción del usuario: el umbral «bueno» está en 200 milisegundos o menos. El Cumulative Layout Shift (CLS) cuantifica los desplazamientos visuales inesperados durante la carga; el límite aceptable es 0,1.
Estas tres métricas se miden de dos formas distintas: con datos de laboratorio (simulados en herramientas como Lighthouse) y con datos de campo (experiencias reales de usuarios recogidas en el Chrome User Experience Report, conocido como CrUX). Los datos de laboratorio son reproducibles y sirven para detectar problemas; los de campo reflejan lo que realmente ocurre en dispositivos y conexiones variadas. Una auditoría seria usa ambos.
Time to First Byte y otras métricas de red
El Time to First Byte (TTFB) mide el tiempo entre que el navegador hace la petición y recibe el primer byte de respuesta del servidor. Un TTFB alto suele indicar problemas en el servidor, en la base de datos o en la falta de caché. Un valor por debajo de 800 milisegundos se considera correcto según los umbrales actuales de Google. Si el TTFB es alto, ninguna optimización de frontend va a solucionar el problema de raíz.
El First Contentful Paint (FCP) y el Total Blocking Time (TBT) completan el cuadro. El FCP indica cuándo aparece el primer contenido visual; el TBT suma el tiempo durante el que el hilo principal del navegador está bloqueado por JavaScript antes de que la página sea interactiva.
Las herramientas de una auditoría de rendimiento web
Ninguna herramienta por sí sola ofrece una visión completa. Lo habitual es combinar varias con propósitos distintos.
Lighthouse y PageSpeed Insights
Lighthouse es un auditor automatizado integrado en Chrome DevTools que analiza rendimiento, accesibilidad, SEO y buenas prácticas. PageSpeed Insights combina los resultados de Lighthouse con los datos reales de CrUX, lo que lo convierte en el punto de partida más completo para una primera evaluación. Eso sí, una puntuación de 90 en Lighthouse no garantiza buenas métricas de campo: los dispositivos de gama baja y las conexiones lentas dan resultados muy distintos a los de la simulación.
WebPageTest
WebPageTest permite ejecutar pruebas desde localizaciones geográficas específicas, con dispositivos reales o emulados y en distintas condiciones de red. Su cascada de recursos (waterfall) es la vista más detallada disponible para entender el orden de carga, los bloqueos y las dependencias entre archivos. Si quieres saber exactamente qué archivo retrasa el renderizado inicial, esta es la herramienta.
Chrome DevTools
El panel de Performance de Chrome DevTools graba una traza completa de la ejecución del navegador: JavaScript, pintado, composición de capas y actividad de la red. Es más técnico que las herramientas anteriores, pero permite identificar funciones JavaScript costosas, animaciones que consumen recursos y problemas de layout que no aparecen en los informes automáticos.
Google Search Console
El informe de Experiencia de página de Search Console muestra los datos de CrUX agrupados por URL y permite identificar qué páginas tienen métricas deficientes según los usuarios reales de Chrome. Es la única fuente que combina datos de rendimiento real con la perspectiva del rastreo de Google.
Problemas más frecuentes y cómo priorizarlos
Tras recopilar los datos, el siguiente paso es ordenar los problemas por impacto real, no por lo que aparece primero en el informe. Algunos fallos tienen más peso que otros.
Imágenes sin optimizar
Las imágenes son históricamente la mayor fuente de bytes innecesarios en una página web. Servir imágenes en formato WebP o AVIF en lugar de JPEG o PNG puede reducir el peso entre un 25% y un 50% sin pérdida visual perceptible. Además, definir atributos width y height explícitos en cada imagen evita el desplazamiento de layout que penaliza el CLS. Si trabajas con WordPress u otro CMS, hay plugins y procesos automáticos para gestionar esto, pero conviene entender el proceso antes de delegarlo. El artículo sobre optimización de imágenes sin perder calidad cubre las opciones más efectivas.
JavaScript que bloquea el renderizado
Los scripts cargados en el <head> sin los atributos async o defer detienen el análisis del HTML hasta que se descargan y ejecutan. Esto retrasa directamente el FCP y el LCP. El primer paso es auditar qué scripts se cargan, desde dónde y con qué prioridad. El segundo es eliminar los que no son necesarios en la carga inicial y diferir el resto. Los scripts de terceros, como los de analítica, publicidad o chat, son candidatos habituales a ser diferidos o cargados bajo demanda.
Falta de caché y configuración del servidor
Sin cabeceras de caché correctas, el navegador descarga los mismos recursos en cada visita. Una política de caché bien configurada puede hacer que los recursos estáticos (fuentes, CSS, JavaScript, imágenes) no se vuelvan a descargar durante días o semanas. El TTFB alto, por su parte, suele resolverse con una CDN que sirva el contenido desde servidores próximos al usuario. Si el sitio recibe tráfico de distintas regiones, una red de distribución de contenido puede reducir la latencia de forma significativa.
CSS no utilizado y fuentes web
Los frameworks CSS como Bootstrap cargan miles de reglas que nunca se aplican en la página. Herramientas como PurgeCSS eliminan las reglas no utilizadas y reducen el tamaño de las hojas de estilo drásticamente. Las fuentes web, por su parte, pueden bloquear el renderizado del texto si no se gestionan correctamente: usar font-display: swap evita el texto invisible durante la carga y mejora el FCP sin sacrificar la tipografía final.
Plugins y scripts innecesarios
En WordPress, cada plugin activo puede añadir sus propios archivos CSS y JavaScript a todas las páginas, aunque solo sea necesario en una. Auditar qué plugins están activos, qué cargan y si realmente se usan es uno de los pasos con mayor retorno en sitios WordPress. Elegir bien los plugins desde el principio es más eficiente que limpiar después. El proceso de selección de plugins sin penalizar el rendimiento merece su propio análisis.
El proceso paso a paso de una auditoría real
Una auditoría de rendimiento web estructurada sigue un orden que evita perder tiempo en síntomas secundarios antes de resolver las causas raíz.
El primer paso es recopilar datos de campo desde Google Search Console y PageSpeed Insights para identificar qué páginas tienen métricas deficientes según usuarios reales. El segundo es ejecutar una prueba de laboratorio con WebPageTest en condiciones representativas (dispositivo móvil de gama media, conexión 4G simulada) para obtener la cascada de recursos y los tiempos por fase. El tercero es revisar el TTFB: si supera el segundo, el problema es de backend y debe resolverse antes de optimizar el frontend.
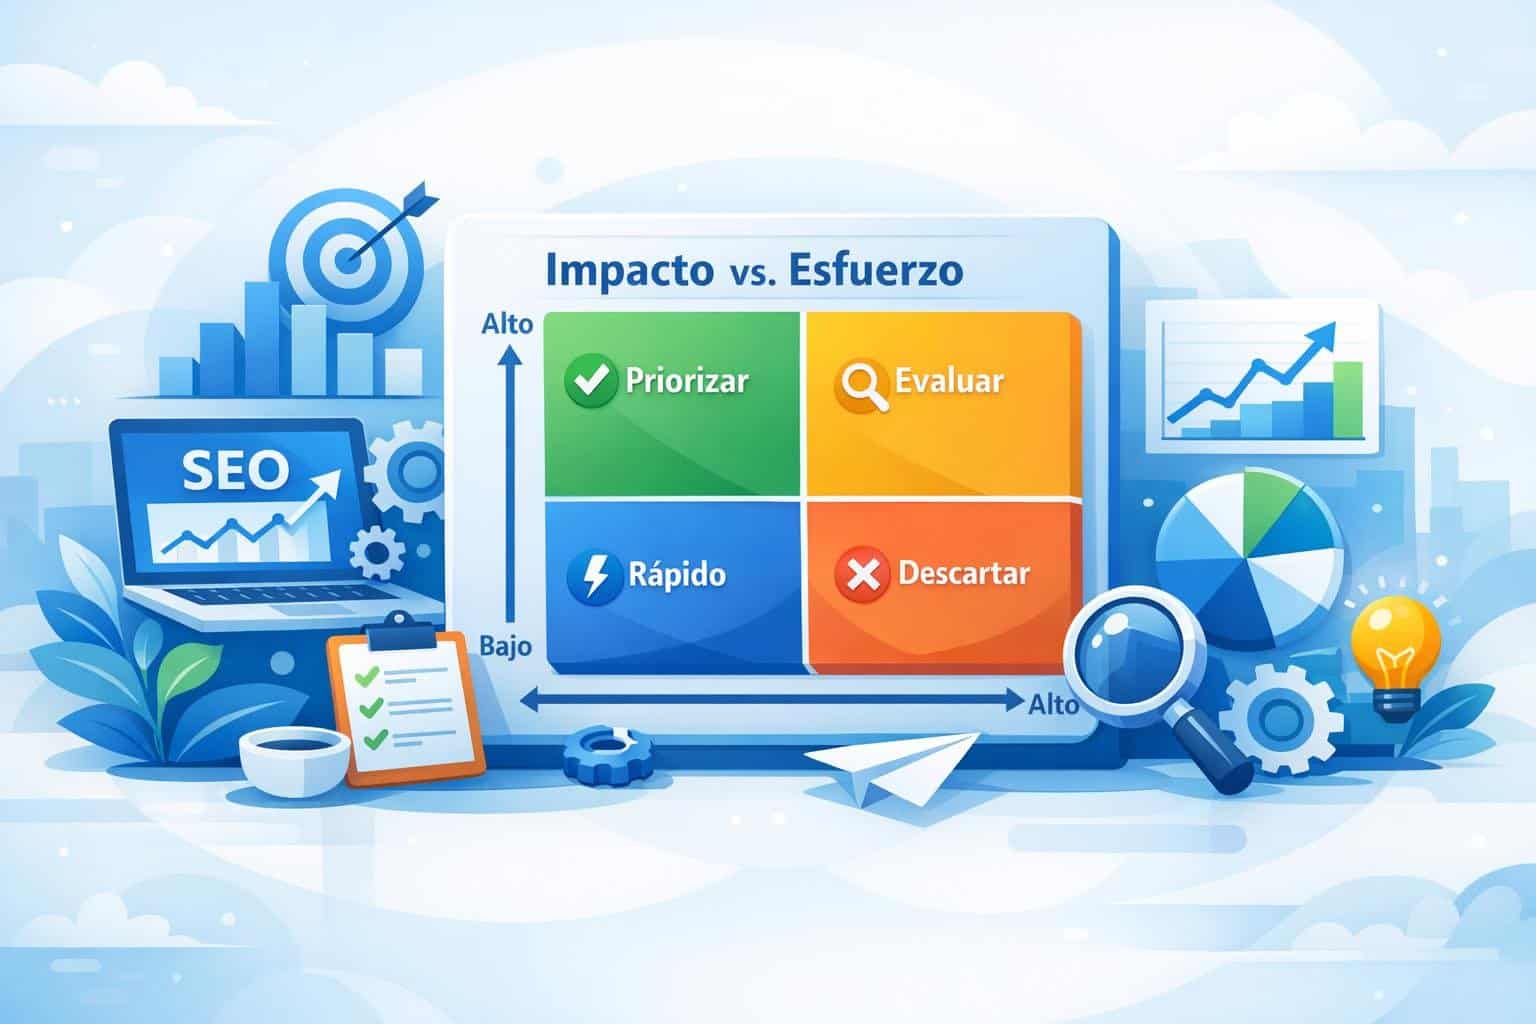
Con esa base, el siguiente paso es priorizar los problemas según su impacto en las Core Web Vitals y el esfuerzo de implementación. Un LCP alto causado por una imagen sin optimizar se resuelve en minutos; un LCP alto causado por un servidor lento puede requerir cambiar de alojamiento o implementar un sistema de caché a nivel de servidor. La diferencia entre ambos escenarios es enorme.
Si el sitio usa WooCommerce o tiene una tienda con muchas variantes, el análisis requiere atención adicional. Las páginas de producto con múltiples scripts de terceros, galerías de imágenes pesadas y funciones dinámicas acumulan problemas de rendimiento de forma especialmente rápida. Las técnicas específicas para reducir el tiempo de carga en WooCommerce son diferentes a las de un blog estático.
Tras aplicar las correcciones, hay que volver a medir con las mismas condiciones iniciales para verificar el impacto real. Este paso se omite con más frecuencia de lo que debería, y es el único que confirma si los cambios han funcionado o si el problema estaba en otro sitio.
Rendimiento y mantenimiento continuo
Una auditoría puntual resuelve los problemas existentes en ese momento, pero el rendimiento se degrada con el tiempo. Cada actualización de plugin, cada nuevo script de marketing, cada imagen subida sin comprimir añade peso a la página. Sin un proceso de revisión periódica, los sitios vuelven a su estado anterior en cuestión de meses.
La monitorización continua con herramientas como SpeedCurve o Calibre permite detectar regresiones automáticamente antes de que afecten a usuarios reales. Integrar métricas de rendimiento en el proceso de despliegue (por ejemplo, con presupuestos de rendimiento en Lighthouse CI) evita que los cambios de código introduzcan nuevos problemas sin que nadie lo note.
Si el sitio pasa por cambios estructurales importantes, como una migración de dominio o un rediseño completo, las auditorías de rendimiento deben realizarse antes y después del cambio. Una migración web mal gestionada puede destruir el trabajo de meses en cuestión de días, tanto en posicionamiento como en métricas de experiencia.
El mantenimiento web regular debería incluir revisiones de rendimiento como parte del ciclo habitual, no como una tarea extraordinaria que se encarga solo cuando algo falla.
Cómo documentar los resultados para que el equipo actúe
Una auditoría que no genera acciones concretas es papel mojado. El informe debe incluir, para cada problema identificado, la métrica afectada, el impacto estimado, la corrección específica y el responsable de implementarla. Los informes que solo listan problemas sin jerarquizarlos ni proponer soluciones concretas tienden a quedar en un cajón.
Una forma efectiva de estructurar el informe es usar tres categorías: correcciones inmediatas (menos de dos horas de trabajo, impacto alto), mejoras a medio plazo (requieren desarrollo o decisiones de infraestructura) y puntos de seguimiento (problemas menores o condicionados a otros cambios). Esta clasificación hace que el equipo sepa exactamente qué hacer primero sin necesidad de interpretar los datos técnicos por su cuenta.
Si el sitio usa un entorno de staging, todas las correcciones deben probarse ahí antes de publicarse en producción. Un cambio de configuración de caché mal aplicado puede dejar el sitio inaccesible, y una modificación de JavaScript puede romper funciones en páginas que no forman parte de la auditoría. El proceso de montar un entorno de pruebas es un paso previo que ahorra más tiempo del que cuesta.
El dato que cambia la perspectiva: mide en móvil, no en escritorio
La mayoría de los problemas de rendimiento se ven en dispositivos móviles de gama media, no en el portátil con el que se desarrolla o se audita. Lighthouse ofrece dos perfiles: escritorio y móvil. Las puntuaciones pueden diferir en 30 o 40 puntos entre uno y otro para la misma página. Google utiliza el índice mobile-first desde 2019, lo que significa que las métricas que determinan el ranking son las del dispositivo móvil. Ejecutar la auditoría únicamente en escritorio y dar por bueno el resultado es uno de los errores más comunes, y también uno de los más costosos en términos de posicionamiento real.
Preguntas frecuentes
¿Con qué herramienta debo empezar si nunca he hecho una auditoría de rendimiento web?
El punto de partida más recomendable es PageSpeed Insights, porque combina los datos de laboratorio de Lighthouse con los datos reales de usuarios recogidos en CrUX. Introduce la URL de tu página y obtendrás tanto métricas simuladas como las experiencias reales de visitantes con Chrome. A partir de ahí, si necesitas más detalle sobre el orden de carga de los recursos, puedes complementar el análisis con WebPageTest. No es necesario usar todas las herramientas a la vez desde el principio.
¿Qué significa exactamente que el TTFB sea alto y cómo se soluciona?
Un Time to First Byte alto indica que el servidor tarda demasiado en responder antes de enviar cualquier dato al navegador, lo que puede deberse a un servidor lento, una base de datos sin optimizar o la ausencia de caché. Google considera aceptable un TTFB por debajo de 800 milisegundos. Antes de tocar cualquier elemento del frontend, este problema debe resolverse, porque ninguna mejora de imágenes o JavaScript compensará un servidor que responde tarde. Las soluciones más habituales son implementar caché a nivel de servidor y usar una CDN que acerque el contenido al usuario.
¿Por qué mi puntuación en Lighthouse es alta pero el sitio sigue cargando lento para los usuarios reales?
Lighthouse ejecuta las pruebas en condiciones controladas y simuladas desde un entorno de escritorio o móvil estándar, lo que no refleja la variedad de dispositivos y conexiones reales de tus visitantes. Los datos de campo recogidos en CrUX, accesibles desde PageSpeed Insights o Google Search Console, muestran lo que realmente experimenta cada usuario con su propio dispositivo y red. Una puntuación de 90 en Lighthouse puede coexistir con métricas de campo deficientes si tus usuarios acceden desde móviles de gama baja o conexiones lentas. Por eso una auditoría seria siempre combina datos de laboratorio y datos de campo.
¿Cada cuánto tiempo hay que repetir una auditoría de rendimiento web?
Una auditoría puntual resuelve los problemas existentes en ese momento, pero el rendimiento se deteriora con el tiempo por cada plugin actualizado, script de marketing añadido o imagen subida sin comprimir. Lo ideal es establecer un proceso de revisión periódica integrado en el mantenimiento habitual del sitio, no tratarlo como una tarea extraordinaria. Herramientas como SpeedCurve o Lighthouse CI permiten monitorizar el rendimiento de forma continua y detectar regresiones antes de que afecten a usuarios reales. Además, cualquier cambio estructural importante como una migración o un rediseño requiere una auditoría antes y después del cambio.
¿Qué debo priorizar si tengo varios problemas detectados y no sé por dónde empezar?
El criterio principal para priorizar debe ser el impacto real en las Core Web Vitals combinado con el esfuerzo de implementación. Lo primero es verificar si el TTFB es alto, porque si el servidor es el cuello de botella ninguna otra mejora tendrá efecto suficiente. Después conviene atacar las correcciones de alto impacto y bajo esfuerzo, como optimizar imágenes o añadir atributos async y defer a los scripts, antes de abordar cambios de infraestructura más complejos. Organizar los problemas en tres categorías, correcciones inmediatas, mejoras a medio plazo y puntos de seguimiento, ayuda al equipo a actuar sin necesidad de interpretar los datos técnicos cada vez.